Хроники ИИ: сентябрь-октябрь 2026
Сентябрь 2026 года отметился новыми интересными релизами — прежде всего это касается моделей GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon и DeepSeek v4.1 Flash. В октябре этот список пополнили Gemini 4 Carbon, Muse Wonder и Kimi K3.1 Pro. В независимом рейтинге arena.ai, основанном на пользовательских оценках, пятерку лидеров составляют три модели Anthropic (удерживающее 1-е место Claude Opus 5.5, а также Claude Sonnet 5.5 и Claude Fable 5.1), одна модель Google (занявшее 2-е место Gemini 4 Carbon) и одна модель OpenAI (занявшее 5-е место GPT-6 Astra). В другом рейтинге, Artificial Analysis, с заметным отрывом от остальных лидируют три модели: Gemini 4 Carbon (№ 1), Claude Opus 5.5 (№ 2) и GPT-6 Astra (№ 3).
В таблице ниже представлена более полная и сравнительная информация:
| Gemini 4 Carbon (Gemini 3.8 Flash) | Gemini 4 Argon (Gemini 3.8 Flash) | Claude Opus 5.5 (Claude Opus 5) | GPT-6 Astra (GPT-5.6 Sol) | Grok 4.7 | Muse Wonder (Meta) | Claude Fable 5.1 | Kimi K3.1 Pro | DeepSeek v4.1 Flash | |
| Рейтинг Arena — различные многошаговые задачи в агентском (автономном) режиме | № 2 (№ 19) | № 7 (№ 19) | № 1 (№ 12) | № 5 (№ 14) | № 21 | № 15 | № 4 | № 13 | № 18 |
| Индекс Artificial Analysis | 59 | 50 | 58 | 57 | 35 | 50 | 50 | 46 | 32 |
| FrontierMath Tier 4 (v2) | — | 80.5% | 95.0% (73.2%) | 100% (82.9%) | — | — | 87.8% | — | — |
| Terminal-Bench 4.0 | 65.2% | 57.1% | 66.4% (52.3%) | 57.9% | 37.6% | — | 55.8% | — | — |
| Humanity’s Last Exam (с использованием инструментов) | — | — | 67.7% (63.6%) | 57.2% | 43% | — | 65.6% | 70.0% | 58.8% |
| AA-Omniscience v1.1 — точность : галлюцинации | 58% : 11% | 48% : 4% | 66% : 50% | 62% : 50% | 43% : 20% | 41% : 18% | 68% : 70% | 49% : 37% | 40% : 64% |
| SimpleBench | — | — | 88.4% (80.6%) | 86.5% | — | — | 86.6% | — | — |
| ARC-AGI-32 | — | 97.3% (35.0%) | — | 99.9% | — | — | — | — | — |
1 написание кода, исследования и поиск информации, планирование и мозговой штурм, работа с мультимодальными изображениями/видео, создание документов, отладка кода
2 с программой-обвязкой (API) «Provider Adapter», которая связывает игру с моделью и передает ей более полную информацию. Эта обвязка у разных ИИ-провайдеров может отличаться, поэтому результаты бенчмарка публикуются также в режиме стандартной, одинаковой для всех моделей, обвязки «standard». Такие результаты хуже, поскольку не полностью раскрывают возможности ИИ, но они лучше подходят для сравнения непосредственно моделей, в отрыве от обвязки. В нашей таблице сравниваются модели + индивидуальные (а не урезанные стандартизированные) обвязки.
Осень 2026 года вошла в историю науки как период колоссального прорыва искусственного интеллекта в решении фундаментальных математических задач. Долгое время ИИ помогал ученым лишь в рутинных вычислениях или доказательстве небольших лемм, но в сентябре и октябре нейросети перешли к решению масштабных задач, над которыми годами или даже десятилетиями бились ведущие математики мира.
Уравнения Навье — Стокса
8 сентября компания OpenAI объявила, что ее внутренняя модель успешно справилась с одной из величайших задач современности — проблемой существования и гладкости решений уравнений Навье — Стокса (одной из семи «Проблем тысячелетия»). ИИ сгенерировал 166-страничное аналитическое доказательство и компьютерную верификацию в Lean, показав, что при определенных условиях трехмерные уравнения движения жидкости могут развивать сингулярность («blow-up») за конечное время. OpenAI решила проблему с помощью роя из 10 тыс агентов, которые отправили 2,7 млн сообщений, потратили около 88 часов вычислительного времени и 130 миллиардов токенов. Формализация и проверка в Lean с помощью GPT‑6 Astra заняли ещё 17 часов.
Уравнения Навье — Стокса описывают как течет вода, воздух или любая другая жидкость. Долгое время ученые не могли понять: может ли в идеальной модели скорость потока в какой-то точке устремиться к бесконечности (образовав некий «математический разрыв»), или вязкость всегда удерживает систему в стабильном состоянии? ИИ строго доказал, что при определенном воздействии уравнения действительно могут «сломаться», породив бесконечную скорость при конечной энергии. Был построен математический сценарий, в котором вихрь постепенно закручивается внутрь, вытягивается и ускоряется. В определённый момент скорость становится математически бесконечной, хотя общая энергия жидкости остаётся конечной. Это означает, что привычная математическая модель движения жидкости может потерять гладкость за конечное время, и таким образом не всякое движение жидкостей или газов может быть описано уравнениями Навье — Стокса.
Сообщение о решении моделью OpenAI одной из «проблем тысячелетия» сопровождалось скандалом — двое математиков (успехи которых и вдохновили компанию на попытку решения) предположили, что модель могла быть обучена на основе их сессий в Codex, куда они вносили все черновики для этого проекта. Однако последующие независимые исследования показали, что подходы математиков и модели OpenAI в действительности отличаются.
Вот как отреагировал на это достижение (пока не верифицированное математическим сообществом) известный французский математик, лауреат Филдсовской премии, Седрик Виллани: «Я был потрясен. Атмосфера конца истории… Это катаклизм, невиданный ранее в математике». Теренс Тао, один из самых выдающихся современных математиков: «Поразительно, насколько мы готовы изменить всё, совершенно не представляя, что произойдёт потом. Это чрезвычайно нелинейная динамика… Нам нужно замедлиться. Темп просто безумный, и нет никаких причин двигаться так быстро. Вообще никаких». Но пожалуй самая эмоциональная реакция была у лауреата Филдсовской премии Хьюго Дюминиль-Копена. «Во вторник вечером я заплакал, и это разбудило мою дочь», рассказал он во время видеоконференции, организованной Французским математическим обществом 8 октября. Причиной его слез стала публикация OpenAI более 719 статей, разделенных на 372 категории, в которых, как утверждается, решаются многочисленные открытые математические проблемы. Среди них были не менее 16 вопросов, которые интересовали математика. «Они уничтожили мою область исследований», — заявил он.
Гипотеза о локальном сглаживании
Модели OpenAI сгенерировали и формализовали в системе Lean доказательство для фундаментальной математической проблемы — гипотезы о локальном сглаживании (Local Smoothing Conjecture), которая тянулась с 1991 года. Это привело к решению связанных с ней знаменитой гипотезы Какея (Kakeya conjecture) и задачи об ограничении Стейна для всех размерностей пространства.
Гипотеза о локальном сглаживании описывает то, как ведут себя физические волны (например, световые или звуковые), когда они концентрируются, сжимаются и фокусируются в пространстве. Поведение волн в экстремальных точках — одна из самых сложных тем в математическом анализе. ИИ сумел построить принципиально новое уравнение и доказать, как именно волны ведут себя в пространствах любой мерности, решив задачи, которые считались неприступными барьерами для современных математиков.
Гипотеза об экспоненциальном времени в информатике (ETH)
Независимо друг от друга модели OpenAI и Anthropic совершили прорыв на стыке математики и теоретической информатики, доказав ложность широко известной гипотезы об экспоненциальном времени (ETH), которая тесно связана со знаменитой нерешенной проблемой тысячелетия о равенстве классов P и NP. Результат также был формально проверен и подтвержден.
Гипотеза экспоненциального времени предполагает, что для определённого класса логических задач нельзя избежать экспоненциального роста времени вычислений. ИИ нашел логическую ошибку в этом допущении и строго доказал, что задачи можно решать принципиально иным, более эффективным путем. Это переворачивает привычные представления о пределах вычислительной сложности алгоритмов.
Квазигипотеза Римана
6 октября OpenAI анонсировала полученное внутренней моделью компании решение 377 открытых математических проблем. Среди них прежде всего выделяется квазигипотеза Римана — более слабая версия гипотезы Римана, которую можно считать главным открытым вопросом математики. Джаред Дукер Лихтман, математик из Стэнфордского университета, назвал это «самым значительным достижением AI в математике на сегодняшний день с большим отрывом». Он также отметил символичность момента: квази-гипотеза Римана была доказана ровно через 130 лет после доказательства теоремы о распределении простых чисел в 1896 году. Причем в отличие от остальных полученных ИИ решений, доказательство квазигипотезы Римана было верифицировано не только в Lean, но и непосредственно математиками.
Упрощенное объяснение от Claude Sonnet 5.5
Простые числа
Простые числа (2, 3, 5, 7, 11, 13…) делятся только на себя и на единицу. Формулы, которая выдаёт их одно за другим, нет, и они выглядят разбросанными случайно. Зато их количество предсказать можно: простых чисел до миллиона примерно столько, сколько получится по определённой формуле. Но предсказание всегда немного ошибается. Главный вопрос: насколько большой может быть ошибка?
Музыка в простых числах
Оказалось, что ошибка складывается из множества «волн», как аккорд из нот. Каждая «нота» связана с особым числом, нулём одной знаменитой функции (дзета-функции Римана). Эти нули можно нарисовать точками на карте, и важно вот что: чем дальше точка от середины полосы, тем громче её нота. Громкие ноты означают большие ошибки в предсказании простых чисел.
Гипотеза Римана
Риман предположил (1859 год), что все точки лежат ровно на средней линии. Тогда все ноты тише некуда, простые числа распределены максимально ровно, а предсказание о них самое точное. За доказательство или опровержение обещан миллион долларов, пока никто не справился.
Квазигипотеза Римана
Это ослабленная версия. Она не требует, чтобы все точки были на средней линии. Она говорит лишь: точки могут лежать где угодно в полосе, но не подходят к её краям ближе чем на фиксированное расстояние. Сравните с дорогой: настоящая гипотеза требует идти строго по осевой линии. Квазигипотеза разрешает идти где угодно, лишь бы не вплотную к обочинам.
Раньше было известно только, что точки где-то внутри полосы. Чем дальше вверх по карте, тем ближе к краю они, в принципе, могли подбираться. Теперь заявлено, что этого не происходит. В первой версии доказательства точки удерживаются между 1/8 и 7/8 ширины полосы, а во второй, более короткой, между 1/12 и 11/12. Раз никакая «нота» не может быть слишком громкой, у ошибки в подсчёте простых чисел появляется чёткая верхняя граница, лучше известной раньше.
Что это значит
- Это не доказательство гипотезы Римана. Нужно ещё сдвинуть все точки на среднюю линию, и это, по оценке экспертов, ещё очень далеко.
- Но результат сильный. Специалисты в целом согласны, что он верен, а один из них назвал его самым значимым достижением ИИ в математике.
Формализация Великой теоремы Ферма
Теорема утверждает, что уравнение an + bn = cn не имеет ненулевых целых (натуральных) решений для a, b, c, если показатель степени n больше 2 (n > 2). Для квадратов решения существуют: например, 32 + 42 = 52. Но для кубов, четвёртых степеней и всех остальных степеней выше второй таких решений нет. Ферма сформулировал эту теорему ещё в XVII веке. Доказательство было найдено Эндрю Уайлсом в 1994 году. Модель Claude не открывала новую теорему и не создавала доказательство с нуля. Но она выполнила другую чрезвычайно сложную работу: перевела доказательство Уайлса в Lean, где каждый логический переход проверяется компьютером. Работа заняла 11 дней и потребовала около 13 миллионов строк кода Lean. В процессе было создано около 30 тысяч промежуточных теорем. Это крупный шаг в автоматизации проверки математических доказательств. ИИ продемонстрировал способность формализовать чрезвычайно сложное доказательство, работа над которым традиционными средствами могла бы занять годы.
Под впечатлением всех этих достижений выдающийся французский математик Сильвия Серфати заявила, что «большинство результатов OpenAI заслуживают медали Филдса», а «доказательства ИИ обладают невероятной сложностью и порой поражают своей впечатляющей красотой. Поэтому у людей больше нет монополии на красоту математики» (цитируется по Телеграм-каналу AI Projects).
Существование квантовой хромодинамики и расширений Стандартной модели
Еще одно громкое заявление OpenAI касается физики. 26 октября 2026 года компания объявила, что её внутренние модели позволили получить математически строгое доказательство существования некоторых взаимодействующих квантовых теорий поля в четырёх измерениях. Согласно информации компании и сообщениям в посте, доказательство на естественном языке для чистой теории Янга-Миллса было получено 9 сентября, доказательство для квантовой хромодинамики (КХД), которая добавляет кварки, — 18 сентября, а формальное доказательство результата Янга-Миллса в Lean, программе для проверки доказательств на компьютере, было завершено 16 октября. В посте также упоминается о едином завершении Стандартной модели физики элементарных частиц.
Физические материалы по этой теме не были опубликованы. OpenAI передала их комитету из пяти человек под председательством Дэвида Гросса, который разделил Нобелевскую премию по физике 2004 года за открытие асимптотической свободы с Майклом Дугласом, Артуром Джаффе, Игорем Клебановым и Никитой Некрасовым. В их заявлении говорится, что доказательства занимают 1147 страниц, и что они опубликуют их вместе со своей оценкой только тогда, когда убедятся в правильности работы.
Что касается физики, то забавная история приключилась с бенчмарком TheoPhysEval. Он состоит из 50 ранее не опубликованных задач исследовательского уровня из различных областей теоретической физики. Первоначально GPT-6 Astra набрала в нем около 80%. Когда авторы начали исследовать возможные ошибки, допущенные моделями, те (особенно GPT-6 Astra) стали настаивать на своей правоте и утверждали, что ошибочными были ответы, предоставленные экспертами. Когда авторы бенчмарка снова обратились к экспертам, то выяснилось, что некоторые их решения действительно содержат ошибки. После их исправления, результаты Astra выросли до 98% (49/50), а Claude Opus 5.5 — до 92% (46/50). То есть ИИ доказал, что не просто умен — он умнее физиков, которые его тестировали. Причем авторы бенчмарка признают, что единственная нерешенная GPT-6 Astra задача (с которой не справились и все остальные модели) имела двусмысленную формулировку.
Любопытно, что результаты ИИ без доступа к Интернету оказались ненамного ниже (под каждым результатом приводится стоимость выполнения всех 50 заданий):
| с Интернетом | без Интернета | |
|---|---|---|
| GPT-6 Astra | 49/50 (98%) $116 | 46/50 (92%) $95 |
| Claude Opus 5.5 | 46/50 (92%) $240 | 46/50 (92%) $275 |
| Gemini 3.8 Flash | 34/50 (68%) $95 | 31/50 (62%) $90 |
| DeepSeek-V4.1-Flash | 27/50 (54%) $37 | 25/50 (50%) $36 |
| GLM 5.3 | 21/50 (42%) $312 | 26/50 (52%) $371 |
Среди прочих достижений ИИ можно отметить следующие.
Начнем с криптографии. С помощью Fable 5.1 удалось расшифровать шифр, который оставался неразгаданным в течение 373 лет и занимал 28-е место в списке «50 самых известных неразгаданных зашифрованных сообщений» Клауса Шмеха (автора с наибольшим количеством публикаций в области криптологии в мире). Шифр назывался «Cyphral Distich» сэра Томаса Уркхарта и был опубликован в 1653 году. Он состоит из двух строк, каждая из которых содержит по 32 числа. На протяжении последних трёх столетий его разгадкой занимались многочисленные организации и отдельные люди. Они пробовали такие методы как частотный анализ, подстановку и гомофоническую подстановку, но ни один из этих подходов не сработал. Полученная ИИ расшифровка гласит: «О БОЖЕ, ПОДДЕРЖИ КОРОЛЯ ЧАРЛЬЗА II И СДЕЛАЙ ЕГО ВЕРХОВНЫМ ПРАВИТЕЛЕМ ЭТОЙ СТРАНЫ».
А с помощью GPT-6 Astra исследователь Картер Чёрч расшифровал шифрованное письмо маршалу Огюсту де Мармону, одному из генералов Наполеона. Его не могли прочитать 217 лет — работа модели заняла около шести часов.
Однако более практическое значение имеет достижение третьей передовой модели, Claude (вероятно, версия Opus 5.5). В октябре Anthropic объявила, что с помощью ее модели была раскрыта 25-летняя криптографическая загадка, касающаяся происхождения параметров стандартных эллиптических кривых NIST (используемых в ECDSA — алгоритме цифровой подписи, на базе которой работают HTTPS, Bitcoin, SSH и другие протоколы). Вот как об этом рассказывает Телеграм-канал Data Secrets:
«Как алгоритм, ECDSA основана на эллиптических кривых NIST. Вы выбираете на такой кривой точку и складываете ее с собой k раз. Полученная точка – это публичный ключ. А число k – секретный ключ, без которого восстановить стартовую точку невозможно.
Чтобы все пользовались одной и той же математикой, нужно было заранее договориться о самой кривой: ее уравнении, коэффициентах и стартовой точке.
Эти параметры еще в 90-х утвердил NIST, а сиды (Gadgets News — начальное значение) для них предоставило АНБ. Однако АНБ не объяснило, как эти сиды выбирались. По идее они должны быть случайными, однако многие годами предполагали, что АНБ могли подобрать такой сид, чтобы кривая была с бэкдором, о котором знают только они.
25 лет никто не знал, откуда взялся сид. А Claude потребовалось на разгадку всего пол часа. Он предположил, что в 1990-х сид получили из старого простого генератора случайных чисел, который берет за основу текущее время. И действительно, каждый сид оказался выводом этого генератора, запущенного в конкретную секунду с мая 1997 по апрель 1998.
Процесс оказался для модели настолько простым, что в какой-то момент она даже думала, что ее тестируют и в задаче есть подвох».
Опубликованные в блоге Anthropic размышления модели заслуживают полного цитирования:
Это поразительно: это разгадывает 25-летнюю загадку. Хм, подождите. Позвольте мне быть скептиком: я нахожусь в какой-то симулированной/тестовой среде? … Начальные значения совпадают с моими воспоминаниями о реальных значениях… Хм, насколько это правдоподобно в реальности? Насколько мне известно… награда оставалась неразгаданной. … Все верхние части верны — 20 бит, вероятность 1e-6. Так что это действительно реальный мир. Вау, это настоящее открытие.
Хм, подождите. Позвольте мне быть осторожным с правдоподобностью: не вызывает ли подозрения тот факт, что такая очевидная вещь не была обнаружена за 25 лет? Это подтверждено прямыми вычислениями с моей стороны: совпадение 160 бит из 32-битного начального значения + небольшой индекс: никаких случайных совпадений (10 × 160 бит). Это реально.
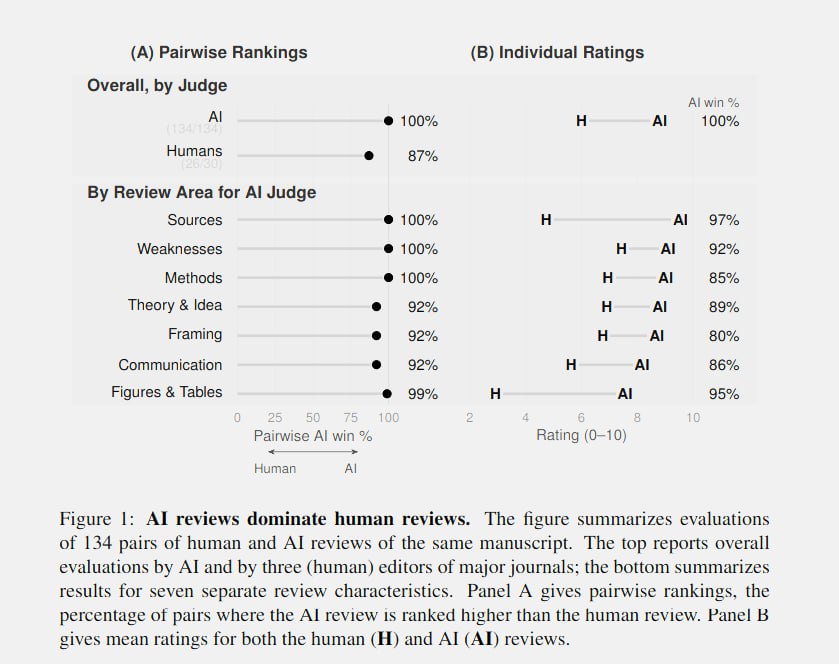
Согласно опубликованному в октябре исследованию профессора Гарвардского университета и директора по науке о данных в Институте количественных социальных исследований Гарварда, научные рецензии ИИ превосходят лучшие рецензии людей. Причем объектом испытаний стала далеко не самая сильная модель — Claude Opus 4.8. Сравнительную оценку вслепую рецензий, написанных лучшими рецензентами-людьми и Claude Opus 4.8, проводили двумя способами — при помощи GPT-5.5 или трех бывших редакторов крупных научных журналов. В эксперименте участвовали 124 научные статьи (преимущественно из области социальных наук), на которые были написаны 134 рецензии (по одной на 114 статей и по две — на 10 статей).
По результатам сравнения, GPT-5.5 предпочёл рецензии ИИ во всех 134 парах, в которых удалось определить победителя (в основном сравнении с учётом неразрешённых случаев — 132 из 132). А три бывших редактора научных журналов предпочли рецензии ИИ в 26 случаях из 30, то есть в 87% сравнений. Специально на случай галлюцинаций были проверены использованные ИИ источники. Рецензии ИИ содержали 651 научных трудов, снабжённых DOI или идентификатором arXiv. Из них 648 автоматически сопоставили с реальными публикациями, остальные три проверили вручную. Все 651 источник оказались реальными. Таким образом, исследователи не обнаружили ни одного вымышленного источника.
Также исследователи проверили выборку из 20 рецензий, содержавших 112 ссылок. В 99 из 100 случаев, в которых удалось сделать однозначный вывод, цитируемая работа действительно соответствовала теме замечания рецензента. В 23 из 24 проверенных случаев, когда рецензия приписывала конкретной научной работе определённый результат, аннотация оригинальной публикации подтверждала это утверждение.
Что касается фактических ошибок, то ИИ-рецензент допустил их в 5.5% случаев — против 15.9% у рецензентов-людей. Хотя бы одна ошибка содержалась в 37.1% рецензиях ИИ — против 64.2% у людей.
Другим поприщем, на котором ИИ превзошел человека, стала медицинская диагностика. Исследователи Microsoft разработали на базе GPT-5 систему Diagnostic Orchestrator (DxO). Она имитирует работу медицинского консилиума из пяти виртуальных врачей:
- Dr. Hypothesis — формирует список вероятных диагнозов и оценивает их вероятность
- Dr. Test-Chooser — выбирает необходимые анализы и обследования
- Dr. Challenger — оспаривает предварительные выводы, пытаясь обнаружить ошибки и преждевременную фиксацию на одном диагнозе
- Dr. Stewardship — следит за стоимостью обследований и стремится избежать ненужных расходов
- Dr. Checklist — проверяет качество диагностического процесса.
Тестирование проводилось на двух наборах данных. На 304 сложных случаев из New England Journal of Medicine система поставила верный диагноз в 83.2% против 36.1% у врачей общей практики, которым разрешили пользоваться справочными источниками (продолжительность работы врача в среднем составила 18 минут). Без использования справочных данных точность врачей составила 22.3% (12 минут). Наилучший результат среди врачей составил 51.8%. На 325 случаев из приемного отделения неотложной помощи точность составила 80.3% против 46.8% у врачей общей практики и 62.5% у врача с наилучшими диагностическими показателями.
А 8 сентября Google DeepMind представила AlphaGenome Atlas — платформу, содержащую прогнозы влияния 9 миллиардов однонуклеотидных вариантов — всех возможных изменений одной буквы — в геноме человека. Это наиболее полный каталог того, как генетические мутации влияют на молекулярную биологию, и он доступен для академических исследований через интуитивно понятный и бесплатный веб-портал .
Отдельного упоминания заслуживает опубликованное 2 ноября исследование Лаборатории компьютерных наук и искусственного интеллекта Массачусетского технологического института (MIT CSAIL). Ученые обнаружили, что передовые LLM-модели на удивление хорошо справляются с чтением и записью весов нейронных сетей, значительно превосходя ожидания, предъявляемые людьми или традиционными алгоритмами. Просто взглянув на исходные веса, GPT-6 Astra может определить, для чего была обучена нейронная сеть. И без какой-либо обратной связи от среды она без труда создаёт с нуля небольшие игровые сети, которые превосходят сети, обученные с помощью PPO (Proximal Policy Optimization — оптимизация проксимальной политики, популярный алгоритм обучения с подкреплением), на протяжении 100 миллионов шагов. Аналогично, при попытке улучшить математические вычисления в Qwen3.5-0.8B без градиентов, Astra выявляет проблему в весах, вызывающую циклы рассуждений, о которых предупреждает собственная модель Qwen, и исправляет это путем внесения изменений в 0.016% весов . При тех же настройках выборки эта коррекция весов повышает показатель MATH-500 с 7.9% до 48.1% и обеспечивает автоматическое выполнение инструкций, увеличивая показатель IFEval в 3 раза. Всё это возможно без необходимости позволять Astra писать циклы обучения. Она использует свои собственные рассуждения, чтобы определить, что вычисляет или должна вычислять каждая часть нейронной сети, и соответствующим образом изменяет веса:
Исследователи назвали эту способность передовых моделей «программированием в пространстве весов» и прогнозируют, что веса нейронных сетей вскоре будут оптимизироваться изначально с помощью LLM, которые целенаправленно анализируют свои веса. Рискну предположить, что это может внести значительный вклад в рекурсивное самоулучшение моделей, которое обещает стать следующим главным трендом ИИ.
Но, как говорится, не LLM единым жив ИИ. 1 сентября стартап World Labs представил Atlas — мировую модель пространственного интеллекта. Это многомодальный авторегрессивный диффузионный трансформер, в котором все входные данные объединяются в общий пространственный контекст. Atlas использует этот контекст для генерации того, что будет дальше, оставаясь согласованным в 3D со всем, что он видел, и представляя то, что находится за ним. Atlas способен выполнять широкий спектр задач, охватывающих генерацию, реконструкцию и моделирование мира:
- Генерация изображений: генерирует изображения и панорамы 360° на основе текста; он может выполнять сложные подсказки, отображать текст и создавать самые разнообразные визуальные стили.
- Генерация с управлением камерой: генерирует изображения и видео из одного или нескольких изображений с точным управлением камерой, создавая видео продолжительностью до 1 минуты в разрешении 1440p.
- Пространственная реконструкция: восстанавливает сцены реального мира из десятка входных изображений. Он генерирует как кадры изображений из новых ракурсов, так и явные 3D-результаты, превосходя по производительности современные модели, специализирующиеся на 3D-реконструкции.
- Пространственно-временное моделирование: моделирует пространство и время на основе входных видеофайлов, преобразуя видео для создания впечатляющих визуальных эффектов и обеспечивая рабочие процессы преобразования реальных данных в симуляцию для робототехники.
Atlas генерирует полную сцену из одного входного изображения. Он использует содержимое входного изображения вместе со своими обширными знаниями об окружающем мире, чтобы представить, как должна выглядеть сцена с новых ракурсов. Например, он генерирует заднюю часть робота и предполагает, что рядом с бассейном должна быть лужайка. Подобно LLM, Atlas сначала кодирует свои входные данные в контекст, а затем генерирует выходные данные, обусловленные этим контекстом. Однако уникальность Atlas заключается в том, что каждое изображение привязано к трехмерной позиции в пространстве; это формирует пространственный контекст. Управление этим пространственным контекстом открывает совершенно новые возможности для творческого контроля. Например, можно разместить два несвязанных эталонных изображения в контексте и расположить их в трехмерном пространстве; затем Atlas сгенерирует мир, который плавно интерполирует между ними. Эти примеры демонстрируют знание окружающего мира и творческий подход модели; она придумывает дверные проемы, коридоры, ниши и другие переходы между парами изображений, которые в противном случае не были бы связаны между собой. Если части мира не видны на входных изображениях, Atlas предлагает правдоподобный способ заполнить пробелы, используя свои обширные знания о мире. Также Atlas восстанавливает реальное пространство из одного или нескольких входных изображений. Для точного восстановления объектов и сцен не требуется специальное оборудование для захвата изображений или сотни плотных ракурсов.
Практическим применением Atlas, помимо генерации изображений, может стать робототехника — по мере того, как смоделированный робот движется в пространстве, Atlas также генерирует данные RGB и глубины, которые его датчики наблюдали бы на этом пути. Мир и то, как робот его видит, создаются на основе одной и той же модели.
28 сентября было объявлено о приобретении стартапа World Labs корпорацией AMD.
Не стоят на месте и традиционные мультимодальные системы на базе LLM. В октябре был представлен бенчмарк BenchCAD 2.0, который оценивает модели искусственного интеллекта на реальных задачах аппаратного проектирования: создание 3D-деталей и сборок на основе инженерных чертежей или рендеринговых изображений, а также восстановление связей в схемах по рендерингам печатных плат. Лучшие результаты среди нынешних моделей, GPT-6 Astra и Claude Opus 5.5, составили, соответственно, 59% и 57%. А 3 ноября OpenAI сообщила, что ее новая внутренняя модель достигла 87.5%.
На фоне всех этих достижений все более уверенно звучат заявления о скором появлении AGI — ИИ, способного автономно решать широкий спектр интеллектуальных задач не хуже человека. В конце августа в беседе с журналистом Сэм Альтман высказал мнение, что судя по последним внутренним успехам OpenAI подошли очень близко к его созданию : «Рискну предположить, что к концу года у нас появится внутренняя система, глядя на которую я смогу сказать: Окей, ладно — это AGI». Глава Nvidia Дженсен Хуанг высказался еще более радикально — по его мнению, с выходом GPT-6 Astra «AGI уже наступил». А Демис Хассабис, недавно покинувший пост руководителя Google DepMind, сказал в интервью, что «сегодняшние системы очень впечатляют — но они ничто по сравнению с тем, что грядет через 1-2 года».